Gemini 偷偷上线了 3.8 Flash,谷歌最近的版本更新有点太快了
Gemini 网页端静默灰度上线 3.8 Flash。一个月内小版本连跳两级,解析谷歌大模型发版策略与 Flash 快速迭代逻辑。
#Gemini #Google #LLM #AI
今天随手在网页端问了 Gemini 一句“你现在是什么模型”,它的回答直接跳出了 Gemini 3.8 Flash。
有趣的是,界面右下角依然显示的是“Flash”,顶部菜单和模型选择标签里也只写着 3.7。当我追问它“为什么前端还显示 3.7”时,它倒是把底层逻辑解释得明明白白:前端 UI 的缓存和文案还没同步,但后端的路由分流已经悄悄切到了新模型。
没有推文官宣,没有博文预热,属于典型的静默灰度上线。
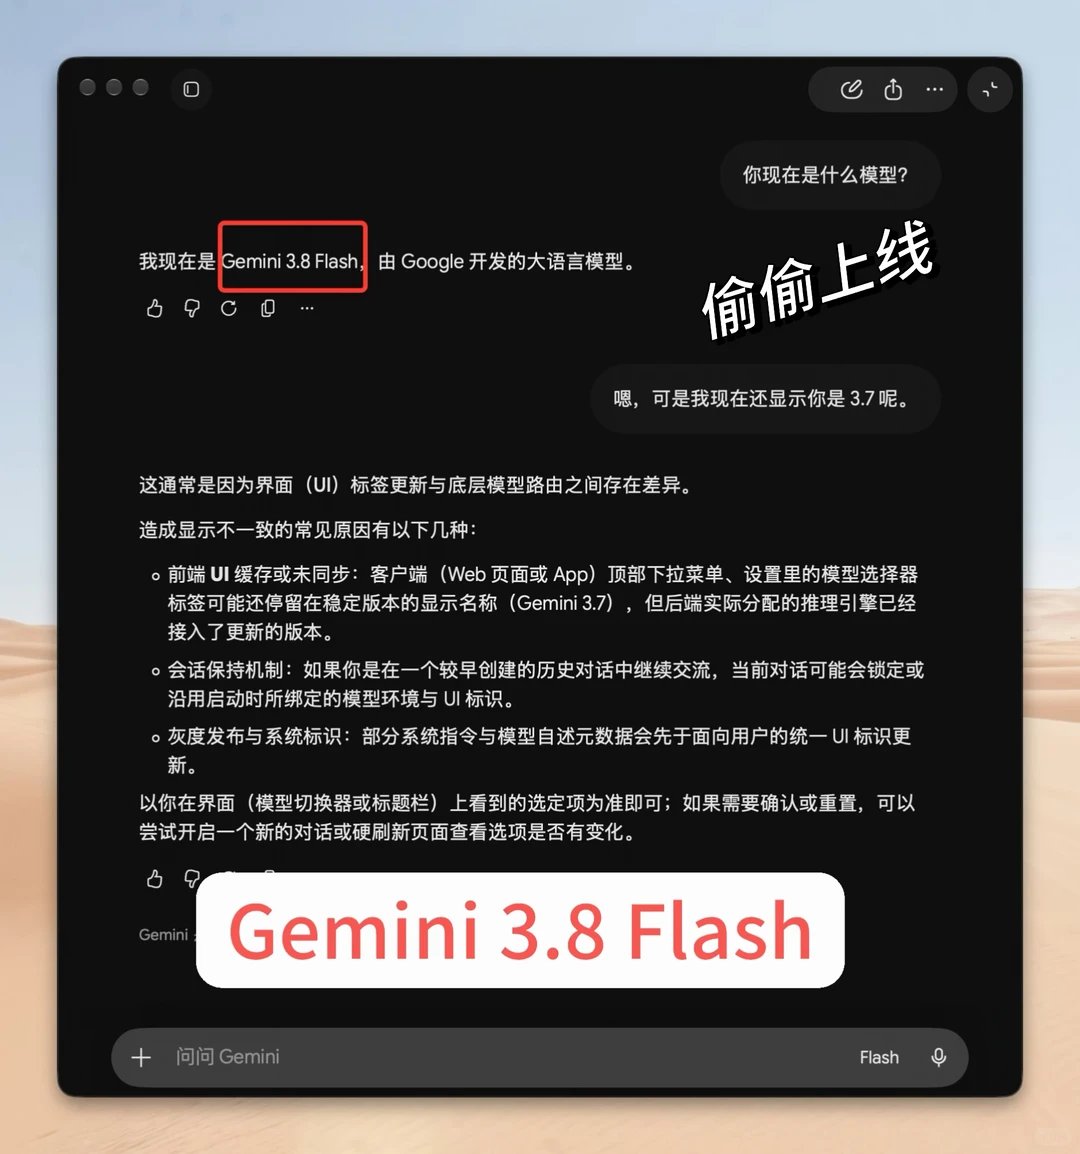
这张截图说明了什么?
看模型自己的回答,其实非常符合现代 Web 服务的灰度发布流程:
- 前端与后端脱节:UI 上的名字是静态配置或发版节奏较慢的资源,而后端模型的 AB 测试和路由切换可以实时调整。
- 渐进式放量:如果你现在去问,可能有的会话依然是 3.7,新开一个对话或者被命中了实验桶,就会拿到 3.8。
这次升级依旧落在了 Flash 上。作为轻量、快速、便宜的模型线,Flash 现在的定位就是做日常任务和快速响应的主力。谷歌把新调整直接先放到 Flash 上跑,用真实的流量来验证效果。
Gemini 最近的发布频率:快得有点反常
回顾一下最近一两个月 Gemini 的动作,节奏明显变了:
- 7 月底:Gemini 3.6 Flash 上线。
- 8 月中旬:推出了 Gemini 3.7 Flash,中间只隔了三周左右。
- 9 月初:现在 Gemini 3.8 Flash 已经开始在生产环境灰度,距离 3.7 的发布甚至还不到三周。
一个月出头的时间,次级版本号从 3.6 一路跳到 3.8。这种高频的发版节奏说明了两件事:
- 版本号的意义在变淡
以前大模型发一个“点版本”(如从 3.0 到 3.5),通常伴随着重大的架构调整或跨越式的性能提升。现在的 .x 更像是一次常规的双周敏捷迭代,改了对齐、补了数据、修了部分特定领域的短板,测试没问题就直接推上线。 - Flash 成了快速迭代的试验田
相比参数量巨大、调用成本高的 Pro 或 Ultra 模型,Flash 拥有极低的推理延迟和成本。谷歌显然选择把高频改动先放到 Flash 上快速试错,让它承担日常最大量的交互。
对于日常写代码、做简单自动化或当搜索工具用的开发者来说,这种“频繁的小修小补”其实体验更平滑。你可能感知不到某一天突然天翻地覆的变化,但模型在默默地换代。
你可以去自己的网页端问问它现在的版本,看看你被分在哪个灰度池里了。